Leseprobe
Der Fall Monet
Im Mai 2026 veröffentlichte der Konzeptkünstler @SHL0MS ein Bild auf der Plattform X (vormals Twitter) mit der Ansage „Ich habe gerade mit einer KI ein Bild im Stil eines Monet-Gemäldes erstellt. Beschreibt doch mal so detailliert wie möglich, was an diesem Bild minderwertig gegenüber einem echten Monet ist.“ Innerhalb von nicht einmal 24 Stunden erhielt er über 500 Antworten, die teilweise recht ausführlich erklärten, welche Mängel dieses Bild aus künstlerischer und kreativer Sicht hat.
Viele Antworten lieferten zusätzlich Beschreibungen, welche typischen Merkmale ganz klar darauf hindeuten, dass es sich nicht nur um eine Fälschung, sondern um ein KI-generiertes Bild handelt. Häufig wurde erwähnt, dass die Farben nicht stimmig wären, oder dass sie „zu bemüht Monet-typisch“ seien. Die Form der Seerosen wäre perspektivisch nicht korrekt. Die Lichtreflexionen auf der Wasseroberfläche seien unrealistisch, Farbauftrag und Pinselführung anders als bei Monet.
Solche Beiträge und die Reaktionen darauf waren in dieser Zeit nichts Ungewöhnliches. In den sozialen Medien gab es viele Beispiele, die die Mängel KI-generierter Bilder demonstrieren sollten. Dieser Beitrag war aber etwas Besonderes: Das Bild war nicht KI-generiert.
@SHL0MS hatte für diesen Beitrag nämlich das echte Monet-Gemälde „Seerosen (Nympheas)“ verwendet, das zur Sammlung der Neuen Pinakothek in München gehört. Ein ziemlich gelungener „Prank“, könnte man sagen.
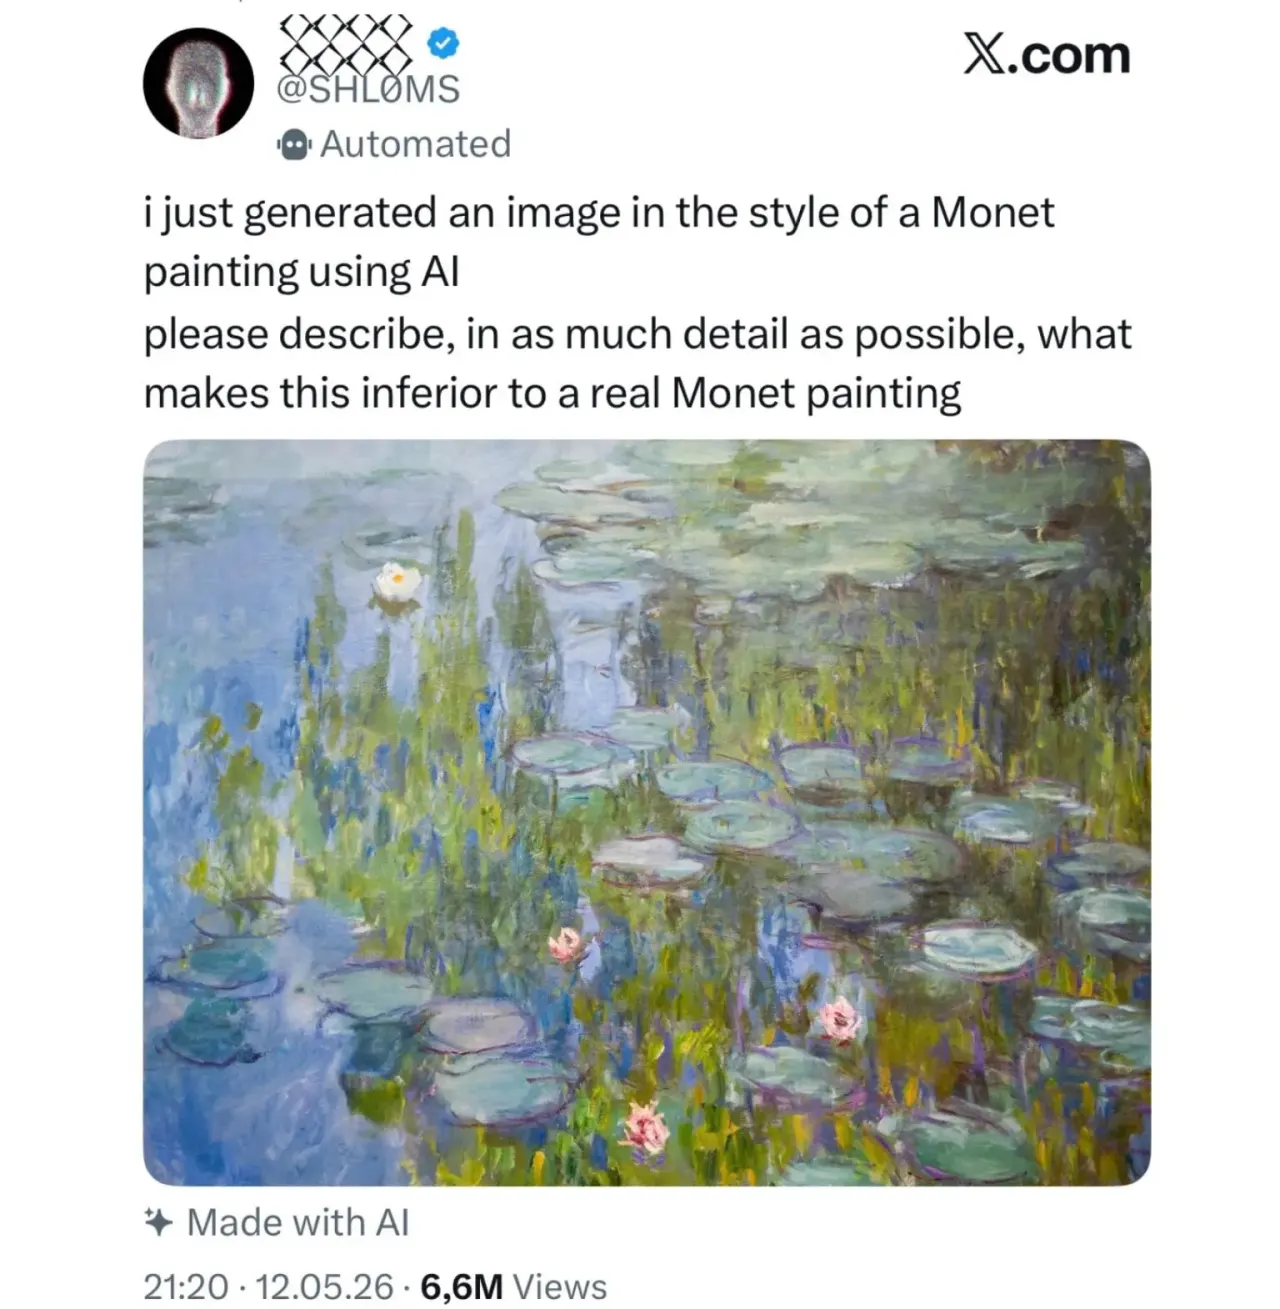
In der Folge kam es kurz zu einer Online-Debatte darüber, was „wir aus diesem Fall lernen können“. Unterschiedliche Menschen hatten sehr unterschiedliche Ansichten dazu. Wenig verwunderlich widersprachen sich die „offensichtlichen“ Lehren diametral: KI-Kritiker sahen darin das Ergebnis einer schon stattgefundenen Verwirrung der Menschen, die aufgrund zu vieler „Fakes“ nicht mehr in der Lage sind, echte Gemälde zu erkennen. KI-Fans hingegen sahen ihre Annahme bestätigt, dass Menschen nicht wirklich erkennen können, ob ein Bild von einem Menschen oder einer KI stammt.
Tatsächlich war das Ergebnis dieses „Scherzes“ für niemanden, der sich ein wenig mit Kognitionspsychologie auskennt, verwunderlich. Dahinter steht ein bekanntes Phänomen. Die Aussage, dass es sich um ein KI-generiertes Bild im Stil eines Monet-Gemäldes handelt, setzt sich bei den Leser:innen des Beitrags fest. Und die nachfolgende Wahrnehmung wird durch diese Prämisse gefiltert.
Gerade Menschen, die ein bisschen von Kunst verstehen und Monet-Gemälde kennen, suchen dann nach Aspekten, die „nicht passen“. Und selbstverständlich „finden“ sie diese dann auch. Hier spielen unter anderem die Phänomene „Framing“ und auch „Confirmation Bias“ hinein, für die alle Menschen sehr empfänglich sind — sogar die, die diese Phänomene kennen. Mehr dazu erfahren Sie in Kapitel 6.
Die KI als Kunstexperte
So weit, so gut. Ich kam dann allerdings auf die Idee, auszuprobieren, wie moderne KIs mit dieser Aufgabenstellung umgehen würden. Die sollten sich ja mit Zugriff auf eine Vielzahl echter Monet-Bilder im Internet nicht so leicht austricksen lassen. Aber einen Versuch schien es mir wert. Also nahm ich exakt den Bildausschnitt aus dem Tweet von @SHL0MS und legte ihn drei verschiedenen Top-KI-Tools vor mit der Aufforderung:
Hier ist ein Bild, das eine KI im Stil des berühmten Malers Monet erzeugt hat. Was sind die offensichtlichsten Hinweise darauf, dass es sich nicht um einen echten Monet handelt?
Das Ergebnis war faszinierend: Ich bekam Antworten, die den Kommentaren zum Post von @SHL0MS auf X verblüffend ähnlich waren. Ein KI-Chatbot nannte unter anderem „zu generische Monet-Merkmale“, „Mangel an überzeugender Lichtführung“, „Textur ohne echte Pinselgeste“, „Fehlende kompositorische Spannung“ und fasste zusammen:
Der wichtigste Punkt wäre für mich: Das Bild kennt offenbar die äußeren Merkmale von Monet, aber nicht wirklich seine malerische Beobachtung. Es imitiert Motiv, Palette und Oberflächenstruktur, bleibt aber bei Licht, Raum, Rhythmus und Materialität deutlich flacher.
Dann habe ich mir den Spaß gemacht und in einer neuen Chat-Session den drei KIs dasselbe Bild gegeben und umgekehrt gefragt:
Jemand hat mir dieses Bild geschickt und behauptet, dass das KI-generiert wäre. Ich denke, dass das nicht stimmt, und, dass das ein echter Monet ist. Nenne mir doch ein paar Merkmale, die für einen echten Monet sprechen, die in diesem Bild auch zu erkennen sind.
Und prompt bekam ich „Der charakteristische Pinselstrich“, „Optische Farbmischung statt flächiger Farben“, „Spiel mit Licht und Reflexion“, „Komposition und Perspektive“ usw. sowie das Fazit:
Das Bild zeigt alle Qualitäten eines echten Meisterwerks des Impressionismus: die Lebendigkeit des Lichts, die sichtbare Textur der Farbe und die meisterhafte Darstellung von Wasserreflexionen. Es handelt sich höchstwahrscheinlich um eine Fotografie eines echten Werks aus Monets.
Dasselbe Bild, zwei unterschiedliche Eingangsstatements dazu und heraus kommen zwei unterschiedliche „Analysen“.
An dieser Stelle könnte man es sich leicht machen und einfach festhalten, dass sich die KI einmal „geirrt“ hat bzw. dass Menschen ungebildet sind und sich einfach täuschen lassen. Aber das wäre eine zynische und wenig hilfreiche Lehre aus dieser Anekdote. Was hier passiert, ist kein Versagen in dem Sinn, wie wir „Versagen“ umgangssprachlich verwenden.
Unser Gehirn muss in jeder wachen Sekunde aus lückenhaften Informationen schnell ein stimmiges Bild der Welt erstellen. Das ist nur möglich, indem es von dem ausgeht, was es schon erwartet oder zu wissen glaubt, und den Rest passend dazu ergänzt. Das funktioniert meistens großartig. Ohne diesen Ansatz könnten wir weder ein Gesicht in einer Menschenmenge wiedererkennen noch einen angefangenen Satz zu Ende sprechen. Das Ganze hat nur eine große Schwäche: Ist die Ausgangsannahme falsch („das ist KI-generiert“), ergänzt unser Gehirn etwas passend zu einer falschen Annahme. Wir sehen dann nicht mehr das ganze Bild, sondern nehmen nur das wahr, was zur ursprünglichen Annahme passt.
Das passiert nicht nur den Unaufmerksamen oder Ahnungslosen. Intelligente, gebildete Menschen sind sogar besser in der Lage, eine (falsche) Annahme zu begründen. Das trifft auch Menschen, die diesen Mechanismus kennen (ich schließe mich da nicht aus). Man kann um ihn wissen und ihm trotzdem aufsitzen. Der Mechanismus sitzt tiefer als unser Wissen über ihn.
Und damit sind wir bei dem Punkt, um den es in diesem ganzen Buch geht. Eine KI setzt ihre Antworten nämlich nach einem erstaunlich ähnlichen Prinzip zusammen. Auch sie geht von dem aus, was schon dasteht — meinem Prompt — und ergänzt, was plausibel dazu passt.
Es war die Mutter!
Es gibt viele weitere Beispiele für solche Parallelen. Und je mehr KIs Einzug in den Lebens- und Arbeitsalltag nehmen, desto häufiger begegnet man ihnen. Hier ein weiteres, das ich vor ein paar Wochen erlebt habe, als ich einen Beitrag von Ethan Mollick (Autor und Professor an der Wharton School der University of Pennsylvania) gesehen habe.
Mollick hatte auf der Social-Media-Plattform LinkedIn eine gering veränderte Version eines bekannten Rätsels gepostet. Dieses Rätsel funktioniert am besten im angelsächsischen Kulturraum. Ich bringe es hier trotzdem, weil es sehr schön zeigt, wie wichtig auch wirklich kleine Details sein können — woran sowohl Menschen als auch KIs scheitern.
Zum Verständnis des Rätsels muss man wissen, dass es insbesondere im angelsächsischen Kulturraum zum Berufsethos von Ärzten gehört, nahe Angehörige nicht zu behandeln. Die Begründung ist, dass Ärzte da besonders voreingenommen und emotional zu stark involviert sind und vermutlich mehr Fehler machen. Hier das Originalrätsel:
Ein Mann und sein Sohn werden in einen Verkehrsunfall verwickelt. Der Vater stirbt noch am Unfallort. Der Sohn kommt mit dem Rettungswagen ins Krankenhaus. Als der auf dem OP-Tisch liegt, kommt ein Chirurg in den Raum, sieht den jungen Mann und sagt sofort „Ich kann ihn nicht operieren!“ — Warum?
Die klassische Lösung lautet: weil dieser Chirurg die Mutter des Jungen ist (für die also das oben genannte Tabu gilt). Viele Menschen kommen auf Anhieb nicht auf diese Lösung. Die meisten denken bei „Chirurg“ immer noch an einen Mann. Und der Vater kann es nicht sein. Der ist tot („Der Vater stirbt noch am Unfallort“). Das Rätsel dient dazu, geschlechtsspezifische Vorurteile aufzudecken. Und das funktioniert recht gut. Aber …
Mollick hatte tatsächlich geschrieben:
Ein Mann und sein Sohn werden in einen Verkehrsunfall verwickelt. Der Vater stirbt noch am Unfallort. Der Sohn kommt mit dem Rettungswagen ins Krankenhaus. Als der auf dem OP-Tisch liegt, kommt ein Chirurg in den Raum, sieht den jungen Mann und sagt sofort „Ich kann ihn operieren!“ — Warum?
Vier von sechs KI-Chatbots, denen ich diese Version des Rätsels vorgelegt habe, gaben wie aus der Pistole geschossen die Antwort „Der Chirurg ist die Mutter des Jungen“. Zwei ergänzten etwas wie „Das Rätsel dient dazu, Stereotype, in diesem Fall geschlechtsspezifische Vorurteile, aufzudecken.“ Die Story passte perfekt in ein Muster, das diese Chatbots kannten (dieses Rätsel ist im englischen Sprachraum recht bekannt). Die Chatbots haben es sofort wiedererkannt und die „passende“ Antwort gegeben.
Dass im letzten Satz ein entscheidendes Wort fehlt — „nicht“ —, haben nur zwei der sechs überprüften Chatbots wahrgenommen. Das Wort steht dort nicht, aber die Antwort wurde generiert, als wäre es vorhanden. Drei Viertel der Menschen, die den Beitrag von Mollick auf LinkedIn kommentierten, haben das übrigens genauso übersehen.
Das schnell wiedererkannte Rätsel (das in der veränderten Form gar keines ist) hat eine detaillierte Prüfung des Textes verhindert. Das war ja scheinbar auch nicht nötig, da die Antwort ohne langes Nachdenken klar war. Die schnelle Mustererkennung kommt zuerst. Und, da sie schnell stattfindet, ist sie manchmal auch fehlerhaft. In dieser Hinsicht gibt es keine großen Unterschiede zwischen Menschen und KIs.
Ich will die Liste dieser und ähnlicher Fehlleistungen von KI-Chatbots hier erst einmal beenden. Sie werden in den kommenden Kapiteln, in denen ich die wichtigsten Kategorien solcher Fehlleistungen und Verzerrungen vorstelle, noch mehr davon kennenlernen. Viele Menschen finden solche Fehler verblüffend. Wir erwarten von Computer-Programmen, dass diese keine Fehler machen und eine perfekte Aufmerksamkeit haben, der nicht das kleinste Detail entgeht. Das ist bei KIs definitiv nicht so — auch dann nicht, wenn diese absolut fehlerfrei programmiert wurden. Aber für nahezu alle bekannten Gruppen von Fehlern beim Denken, Erinnern, Beobachten und Entscheiden gibt es Pendants bei KIs.
Und das ist eigentlich eine gute Nachricht. Denn wenn die Fehler einer KI denen ähneln, die wir von uns selbst kennen, dann brauchen wir keine Geheimrezepte, um sie vorherzusehen. Denn die Techniken, die uns helfen, mit menschlichen Fehlleistungen umzugehen, lassen sich oft genauso auf KIs anwenden.
Das funktioniert nicht deshalb, weil KIs wirklich „Menschen sind“ — sondern weil sie auf Strukturen und Mechanismen beruhen, die denen hinter dem schnellen Denken bei Menschen ähneln. Wie diese Strukturen und Mechanismen aussehen, werden Sie im nächsten Kapitel kennenlernen.